Les Transformers : Un voyage au coeur du Deep Learning !
Comment ces architectures ont-elles transformé l’intelligence artificielle ?
Découvrez leur fonctionnement, leurs avantages et leurs applications concrètes en entreprise.
Les Transformers, de quoi parle-t-on ?
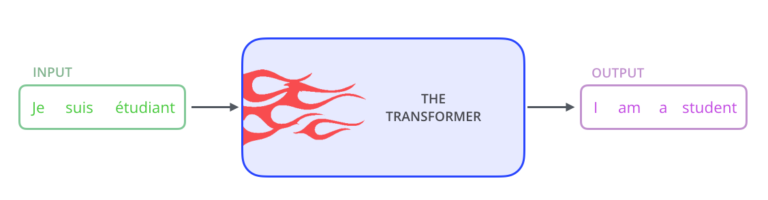
Les Transformers sont une famille d’architectures de réseaux de neurones artificiels appartenant au Deep Learning. Leur particularité ? Ils utilisent un mécanisme appelé attention pour identifier les relations entre les différents éléments d’une séquence.
Introduite en 2017, cette architecture a profondément marqué le traitement automatique du langage naturel. Elle est notamment à l’origine de nombreux modèles d’intelligence artificielle générative capables de comprendre et de produire du texte.
À retenir : un Transformer ne traite pas chaque mot indépendamment. Il analyse les relations entre les mots et leur contexte pour construire une représentation plus riche du contenu.
Traduction automatique
Traduire un document d’une langue à une autre en tenant compte du contexte et du sens des phrases.
Génération de texte
Rédiger des contenus, reformuler des textes, résumer des documents ou répondre à des questions.
Reconnaissance vocale
Transcrire la parole en texte et contribuer à la compréhension de contenus audio.
Classification et analyse
Analyser des commentaires, détecter des sentiments ou orienter automatiquement des demandes.
Comment fonctionne un Transformer ?
Les Transformers reposent principalement sur des mécanismes d’attention qui permettent au modèle d’évaluer l’importance des différents éléments d’une séquence. Contrairement aux réseaux de neurones récurrents (RNN), ils peuvent traiter en parallèle les positions d’une séquence pendant leur entraînement.
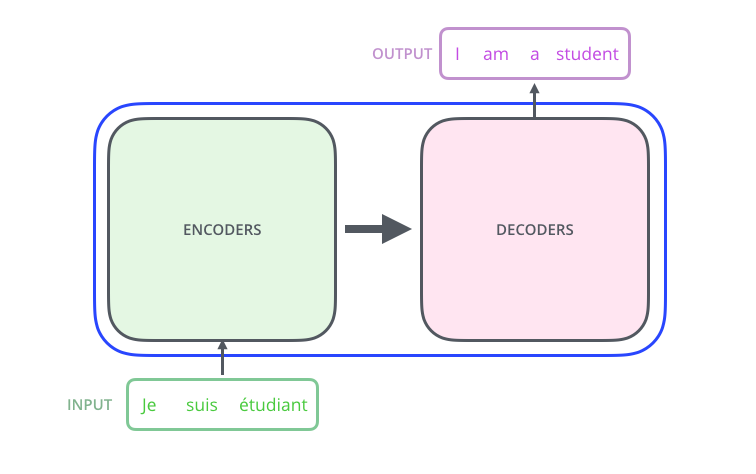
Dans l’architecture originale présentée en 2017, le modèle est composé de deux grandes parties : l’encodeur et le décodeur. D’autres architectures modernes, comme celles de nombreux grands modèles de langage, peuvent utiliser uniquement un décodeur.
L’encodeur : comprendre le contexte
Il transforme la séquence d’entrée en représentations numériques contextualisées. Chaque élément peut ainsi être interprété en tenant compte des autres éléments pertinents.
Le décodeur : générer une sortie
Dans l’architecture originale, il exploite les représentations de l’encodeur et les éléments déjà générés pour produire une séquence de sortie, par exemple une traduction.
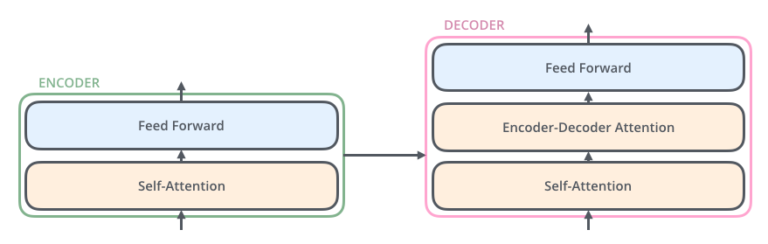
Les composants essentiels
🎯 Le mécanisme d’attention
Il permet au modèle de pondérer les informations utiles dans le contexte. L’attention multi-têtes effectue plusieurs calculs d’attention en parallèle afin de capter différents types de relations.
⚙️ La normalisation
La normalisation par couches contribue à stabiliser les calculs et facilite l’entraînement de réseaux profonds.
🔗 Les connexions résiduelles
Elles ajoutent les informations d’une couche à sa transformation, facilitant la circulation du signal et l’apprentissage de représentations complexes.
📍 L’information de position
Comme l’attention seule ne représente pas naturellement l’ordre des mots, le modèle doit disposer d’informations de position, selon l’architecture utilisée.
Pour approfondir le sujet avec des illustrations pédagogiques, consultez l’article de Jay Alammar, The Illustrated Transformer.
Quels sont les avantages des Transformers ?
Les Transformers ont marqué une avancée majeure dans l’apprentissage automatique. Leur architecture présente plusieurs atouts par rapport aux approches traditionnelles, notamment les réseaux de neurones récurrents.
🚀 Parallélisation
Lors de l’entraînement, les positions d’une séquence peuvent être traitées en parallèle, ce qui améliore l’efficacité des calculs.
🔍 Contexte riche
Le mécanisme d’attention aide à relier des éléments éloignés dans un texte et à exploiter les dépendances à longue distance.
🧩 Polyvalence
La même famille d’architectures peut être adaptée à de nombreuses tâches, du classement de textes à la génération de contenu.
📈 Passage à l’échelle
Les architectures Transformer peuvent être entraînées sur de grands volumes de données et avec un nombre élevé de paramètres.
🎓 Apprentissage par transfert
Un modèle préentraîné peut être adapté à un besoin spécifique, par exemple à l’aide de données métier ou d’un ajustement ciblé.
💡 Nouveaux usages
Ils constituent une base technologique importante pour de nombreux assistants conversationnels et outils d’IA générative.
Un point de vigilance : les Transformers ne sont pas systématiquement plus rapides ou moins coûteux. Leur consommation de ressources, notamment pour les longues séquences, dépend de l’architecture, de la taille du modèle et de son utilisation.
Un cas d’usage concret : la classification des tickets de maintenance
Imaginez une entreprise qui reçoit chaque jour des centaines, voire des milliers de tickets de maintenance. Les demandes concernent des sujets variés : problèmes de connexion, incidents applicatifs, accès aux outils ou demandes d’assistance.
Les équipes doivent analyser chaque demande et la transmettre au bon service. Une tâche répétitive qui peut mobiliser beaucoup de temps.
Comment un Transformer peut-il aider ?
« Bonjour, je n’arrive plus à me connecter au réseau de l’entreprise depuis ce matin. Ma connexion Internet semble coupée. »
Catégorie prédite : Problèmes de réseauLe modèle analyse le contenu du ticket et prédit la catégorie la plus appropriée. Selon le niveau de confiance et les règles définies par l’entreprise, la demande peut ensuite être dirigée automatiquement vers l’équipe concernée ou soumise à une validation humaine.
Quels bénéfices pour l’entreprise ?
Le tri des demandes est automatisé, ce qui réduit les tâches administratives répétitives.
Les tickets sont dirigés vers les équipes compétentes, selon les catégories et les règles définies.
Le modèle peut exploiter le contexte et des formulations variées, y compris lorsque les utilisateurs décrivent un même problème différemment.
Le dispositif peut traiter un grand nombre de demandes, sous réserve des capacités techniques disponibles.
Les catégories de tickets permettent d’identifier les incidents récurrents et les pistes d’amélioration du service.
Pour obtenir de bons résultats, l’entreprise doit néanmoins disposer de données pertinentes, définir des catégories adaptées et surveiller régulièrement les performances du modèle. Une réévaluation ou un réentraînement peut être nécessaire lorsque les demandes évoluent.
Les Transformers : une technologie clé du Deep Learning
Grâce à leur mécanisme d’attention, les Transformers ont renouvelé de nombreuses approches du traitement automatique du langage et contribué à l’essor de l’intelligence artificielle générative.
Comprendre leur fonctionnement, c’est mieux appréhender les technologies qui alimentent aujourd’hui de nombreux outils d’IA et identifier les opportunités qu’elles peuvent offrir aux entreprises : automatisation de tâches, meilleure exploitation des données textuelles et amélioration des processus métier.
Le véritable enjeu ? Choisir le bon modèle, l’adapter au besoin métier et l’intégrer de manière pertinente dans les processus de l’entreprise.