Ontologie Microsoft Fabric : mon retour d’expérience, de la modélisation aux agents de données
Brancher une ontologie Microsoft Fabric sur un agent de données le rend-il plus fiable qu’un agent branché directement sur un modèle sémantique Power BI ? C’est la question que je me suis posée en testant la fonctionnalité de bout en bout, avec un jeu de données de démonstration et un vrai raisonnement d’utilisateur métier.
La promesse de Microsoft est séduisante : une ontologie définit une fois pour tout le vocabulaire de l’entreprise (clients, magasins, ventes, produits), les liens entre ces concepts et les règles qui leur donnent du sens, pour que les agents d’IA répondent avec le langage de l’organisation plutôt qu’avec des noms de tables et de colonnes. Sur le papier, c’est la pièce qui manque entre les données et les agents.
Pour vérifier, j’ai préparé deux modèles sémantiques identiques (un en Direct Lake, un en import), construit une ontologie sur chacun, puis créé quatre agents de données : avec et sans ontologie, en Direct Lake et en import.
Je leur ai posé les mêmes questions, en partant de questions simples (un indicateur, une période) vers des questions plus complexes (plusieurs niveaux de relations, segmentation, vocabulaire métier à traduire).
Je n’ai volontairement pas évité les pièges : données sales, relation désactivée, expression métier qui n’existe pas telle quelle dans les données, question hors périmètre. Le but était de simuler un utilisateur qui ne connaît ni le modèle ni les tables.
Cet article détaille ce qu’est l’ontologie Fabric, les limites rencontrées de la préparation à l’utilisation, les résultats des tests (réponses, scores, erreurs), ce qui m’a surpris, puis les points de vigilance et mes recommandations. Un détail a changé ma lecture de tout le reste : l’agent affiche la trace de ce qu’il a fait, et cette trace montre que l’ontologie ne sert pas du tout à ce qu’on imagine.
Qu’est-ce que l’ontologie Fabric ?
L’ontologie (preview) est un item de Microsoft Fabric IQ qui décrit le vocabulaire métier d’une organisation (concepts, propriétés, relations, règles) et le relie aux données réelles, pour que les personnes, les applications et les agents d’IA utilisent le même langage. Dans la documentation Microsoft, elle joue le rôle de couche de contexte et de modélisation sémantique entre les données et les expériences qui les consomment.
Concrètement, elle permet de :
- définir des types d’entités (un client, un magasin, une vente) avec leurs propriétés ;
- décrire les relations entre ces entités (une vente est réalisée dans un magasin) ;
- relier ces définitions aux données par des liaisons de données (data bindings) vers un lakehouse, un eventhouse, un entrepôt ou un modèle sémantique ;
- porter des métriques (les mesures DAX d’un modèle sémantique) et des règles métier écrites en langage naturel ;
- organiser le tout avec des espaces de noms, de l’héritage et des versions nommées ;
- servir de contexte à des agents, dont l’agent de données Fabric.
Ce qu’elle ne fait pas. Microsoft précise que l’ontologie n’est pas un moteur de requête : elle ne calcule rien et ne répond pas aux questions elle-même. Elle contient des définitions (ce qu’est une vente, un magasin) et des liaisons (quelle table ou quelle colonne alimente chaque concept). Quand on pose une question, c’est l’agent ou l’outil qui l’utilise qui interroge les sources, en s’aidant de l’ontologie pour comprendre les mots.
Elle n’est pas non plus un second entrepôt de données : les données restent là où elles sont.
Enfin, le graphe est un complément facultatif. Il faut distinguer l’ontologie et le graphe. L’ontologie décrit les types d’éléments et leurs liens possibles, sans les données : par exemple « un client peut acheter un produit » ou « un magasin est géré par un employé ».
Le graphe, lui, contient les données réelles sous forme de nœuds (Marie, la cafetière X, le magasin de Nantes) reliés par des arêtes (« a acheté », « est géré par »). Il permet de suivre ces liens étape par étape, d’une donnée à l’autre : de Marie à ses achats, puis des achats au magasin où ils ont eu lieu.
C’est utile quand le chemin entre les éléments compte : retrouver le responsable d’un responsable, savoir ce qu’un changement impacte, ou chercher le plus court chemin entre deux éléments. En revanche, il n’est pas fait pour les calculs courants comme un total ou une moyenne, où les requêtes sur le modèle sémantique restent plus adaptées. Le graphe de l’ontologie ne charge pas les données par défaut : il faut choisir de le matérialiser.
Deux expériences coexistent
Pendant mes tests, j’ai croisé deux versions de l’ontologie. Le tableau résume ce que j’ai observé et ce que la documentation indique.
Tableau :
| Ancienne expérience (1) | Nouvelle expérience (2) | |
|---|---|---|
| Construction | Entités liées à des tables du lakehouse, génération depuis un modèle sémantique, ou construction manuelle | Idem |
| Vues dans l’interface Fabric | Une seule : « Relation » | Trois : Relation, Traçabilité, Ontologie complète |
| Modèle | Entités à clé, relations avec table de jointure | Entités sans clé, hiérarchies, héritage, espaces de noms, métriques, règles, versions nommées |
| Statut | À migrer : retrait annoncé le 31 janvier 2027 | Expérience par défaut pour tout nouvel item |
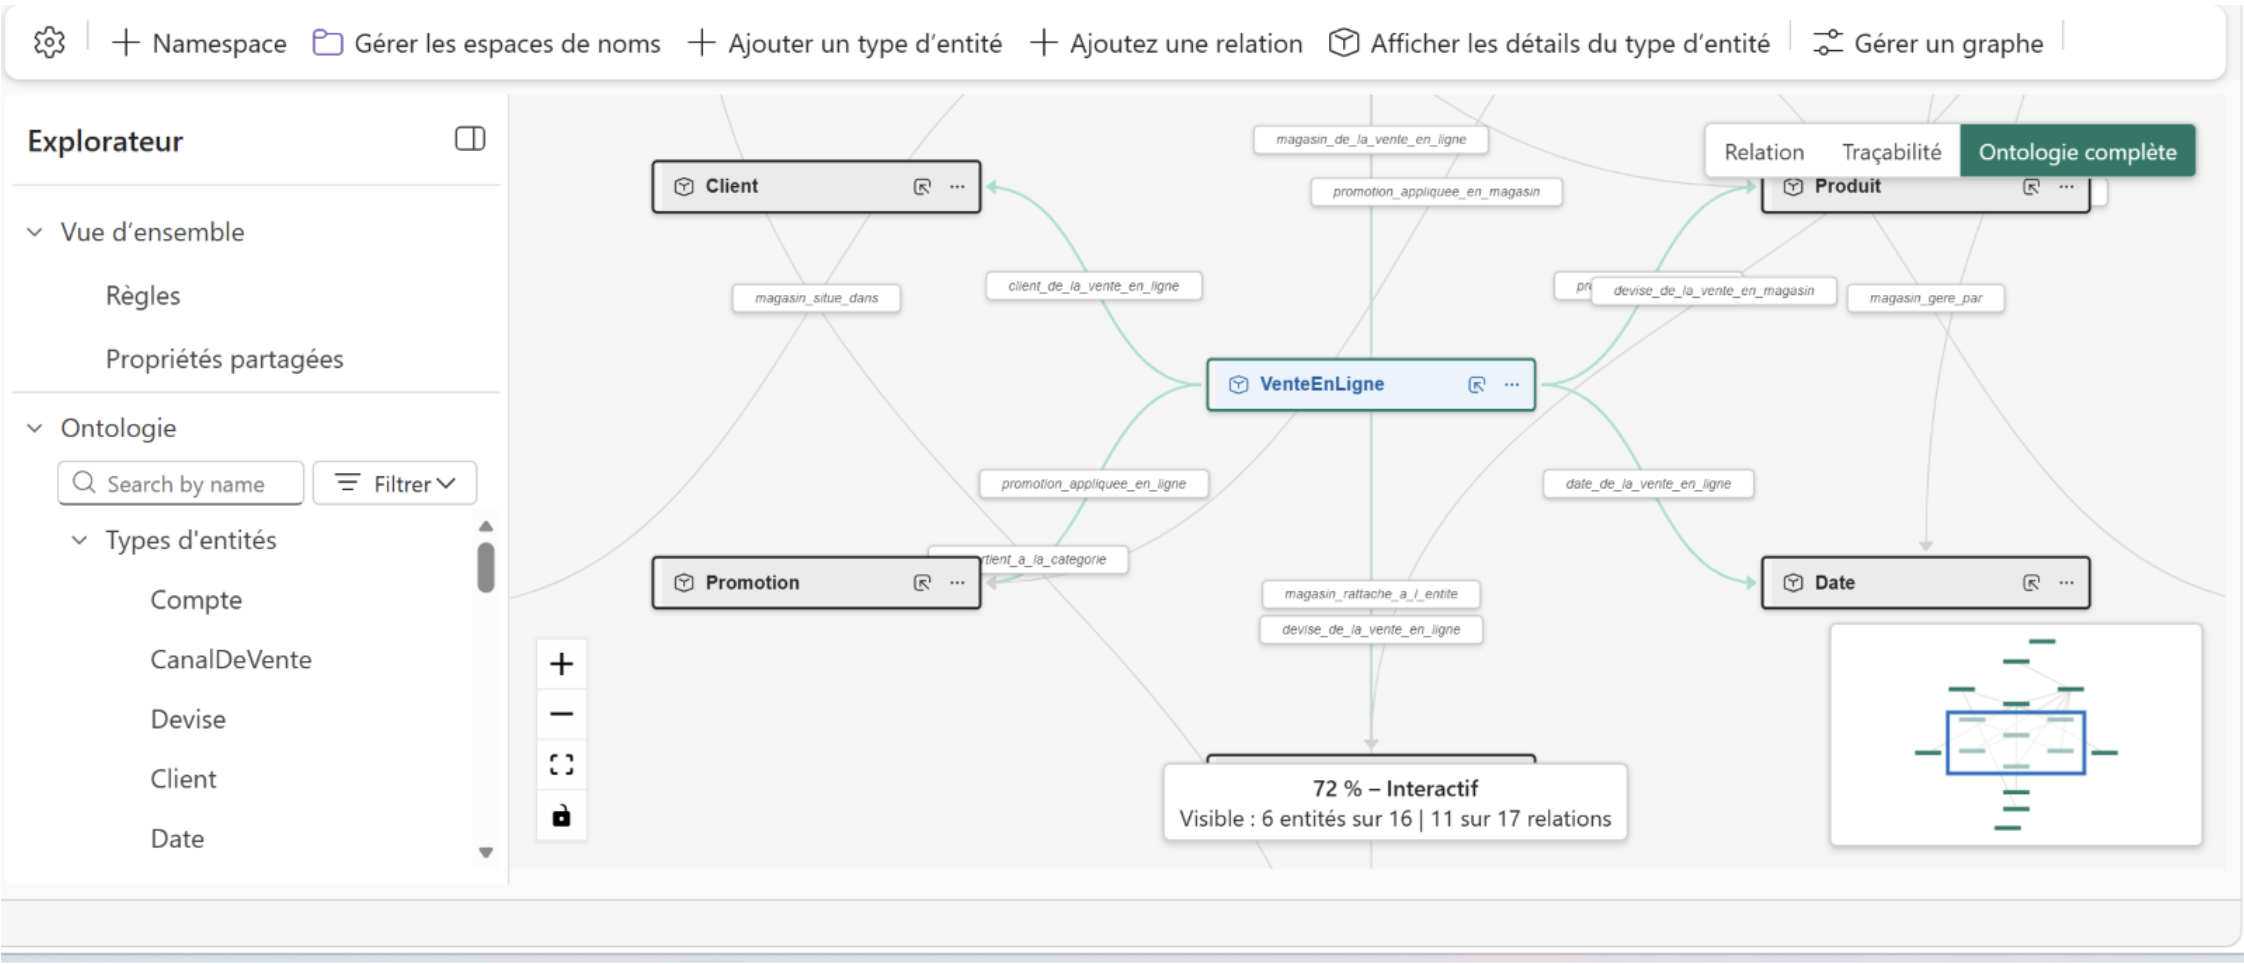
La nouvelle version m’a paru nettement meilleure que l’ancienne. Microsoft indique qu’on ne peut plus créer d’ontologie de l’ancienne expérience depuis l’interface, et propose une action de copie vers la nouvelle expérience pour les ontologies existantes (agents, tableaux de bord et règles sont à reconnecter ou recréer ensuite).
Prérequis à anticiper
- Réglages du tenant. Un administrateur Fabric doit activer les réglages liés à l’ontologie et, pour les agents, le type d’item « Data agent » (preview). Les réglages Azure OpenAI autorisent un traitement des données hors de la région de la capacité : à valider avec la DSI avant activation.
- Un modèle sémantique propre, si l’on génère l’ontologie depuis un modèle : publié, hors de « Mon espace de travail », avec des tables visibles et des relations définies.
- Des types compatibles. D’après la documentation, Graph ne gère pas encore le type Decimal (les propriétés reviennent à null, il faut passer en Double), et les noms de propriétés identiques entre entités doivent avoir le même type.
Ces éléments viennent de la documentation Microsoft Learn à la date où j’écris (15 octobre 2026) : la fonctionnalité reste en préversion et ces points sont à re-vérifier avant toute décision.
De la préparation à l’utilisation : les limites rencontrées
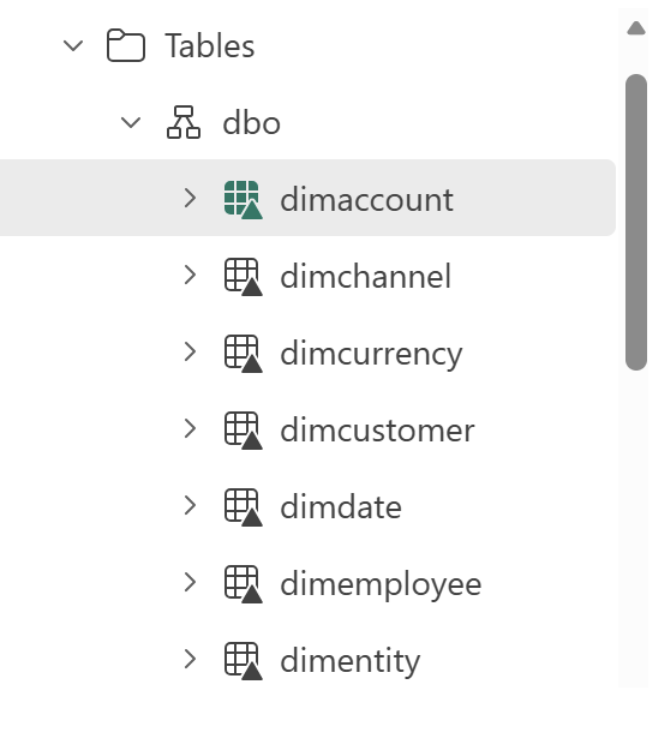
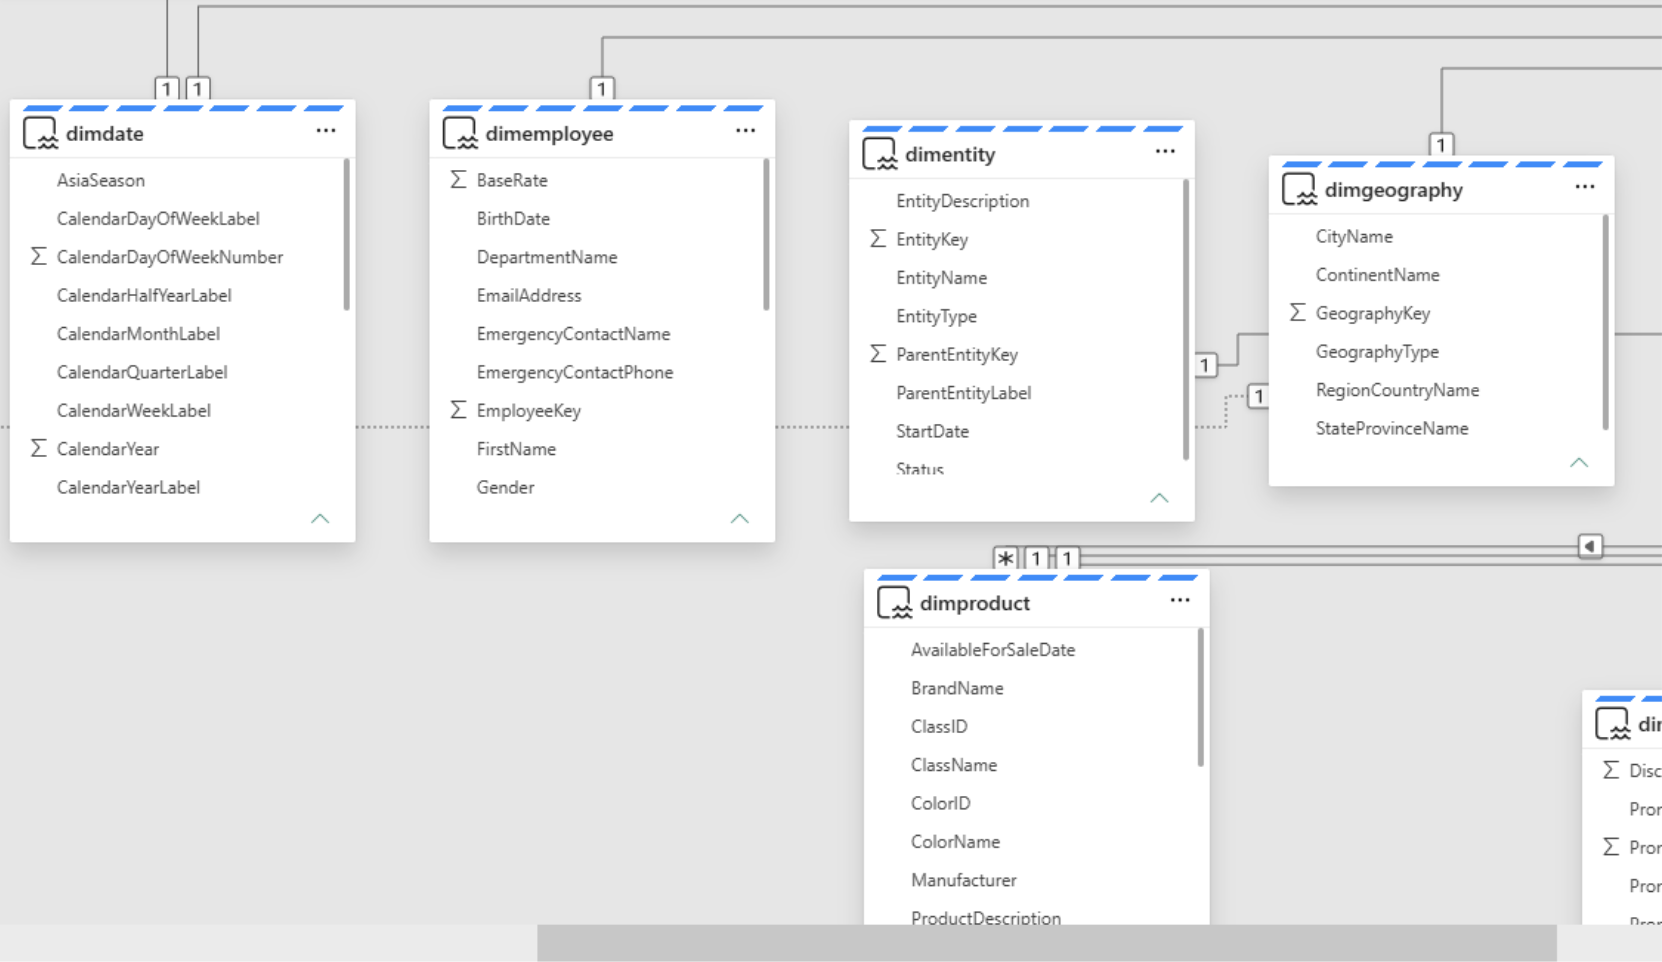
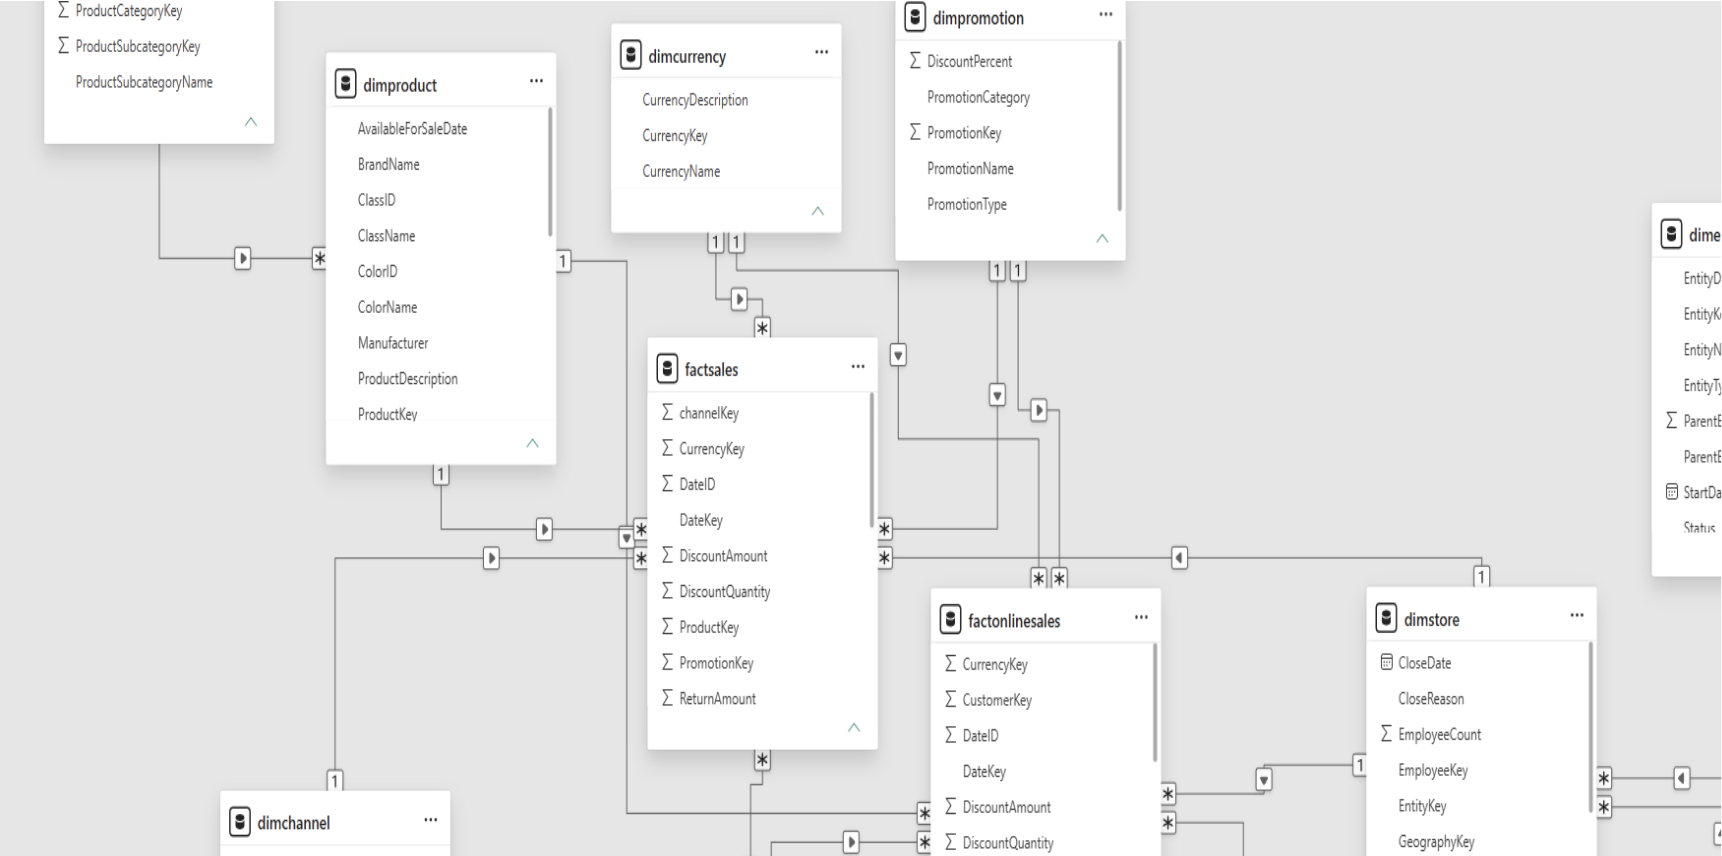
Je suis parti d’un espace de travail Fabric et du jeu de démonstration Contoso (un distributeur fictif d’électronique), chargé dans un lakehouse (img 3) : 27 tables Delta, dont 18 dimensions et 9 tables de faits, avec des ventes de 2007 à 2009, toutes en dollars. Le point de départ était un modèle sémantique Direct Lake (img 4), sans relations initialement, et un second modèle en import (img 5). Le travail en amont a été bien plus long que la création de l’ontologie elle-même.
Préparer le modèle sémantique
- Des relations à reconstruire. Le modèle ne contenait pas de relations. J’ai dû créer les 46 relations, en les déduisant des colonnes de clés communes (*Key).
- Deux relations rendues inactives. Power BI refuse les chemins de filtre ambigus. J’ai désactivé
dimcustomer→dimgeography(sinon la géographie filtrerait les ventes en ligne à la fois par le client et par le magasin) etdimmachine→dimstore(un incident est déjà relié au magasin et à la machine). Cette désactivation aura des conséquences plus tard, sur une question de test.
Les résultats complets du test
Consultez le protocole, les scores et l’analyse des réponses.
Contenu réservé
Données et anomalies du jeu de test
Cette partie complète l’article avec les éléments détaillés du protocole et des résultats.
Des défauts de données bien réels. 10 % des ventes en magasin (338 898 lignes) et 13,6 % des ventes en ligne (1,7 million de lignes) pointent vers un produit absent du référentiel. Les prix unitaires de dimproduct sont en texte, un identifiant parent est décimal dans un modèle et entier dans l’autre, et une colonne parasite _c0 traîne
- Des marques en double à cause d’un espace. « Contoso » et « Contoso␣ » (avec un espace final) existent séparément, idem pour Litware et Fabrikam, et deux marques valent « 1 » et « 18 ». 61 produits n’ont pas de sous-catégorie, et le nom d’une catégorie finit lui aussi par un espace (« Cameras and camcorders␣ »). Ces défauts m’ont servi plus tard : ils permettent de mesurer comment chaque agent réagit à des données sales.
Direct Lake ou import : un chantier à part
- Un passage de Direct Lake à l’import. Les tables du deuxième modèle étaient en Direct Lake, car elles proviennent du lakehouse. Je les ai passées en import.
- Une actualisation qui échouait. Pour récupérer les données, j’ai dû actualiser le modèle en import. Il utilisait la connexion par défaut, sans identifiants explicites : j’ai dû configurer une connexion cloud dans l’interface Fabric.
- Des tables de dates automatiques parasites. Power BI Desktop a ajouté 10 tables de dates automatiques (
LocalDateTable_*), inutiles et gênantes pour une ontologie. D’où l’importance de désactiver la date/heure automatique dans Power BI Desktop et de créer une table calendrier séparée. - Une comparaison à structure identique. J’ai ensuite aligné le modèle Direct Lake sur les mêmes 16 tables et les mêmes 19 relations (dont 2 inactives), puis vérifié que les requêtes de contrôle renvoyaient les mêmes résultats. C’est ce qui permet de parler d’une comparaison « ISO ».
Créer l’ontologie
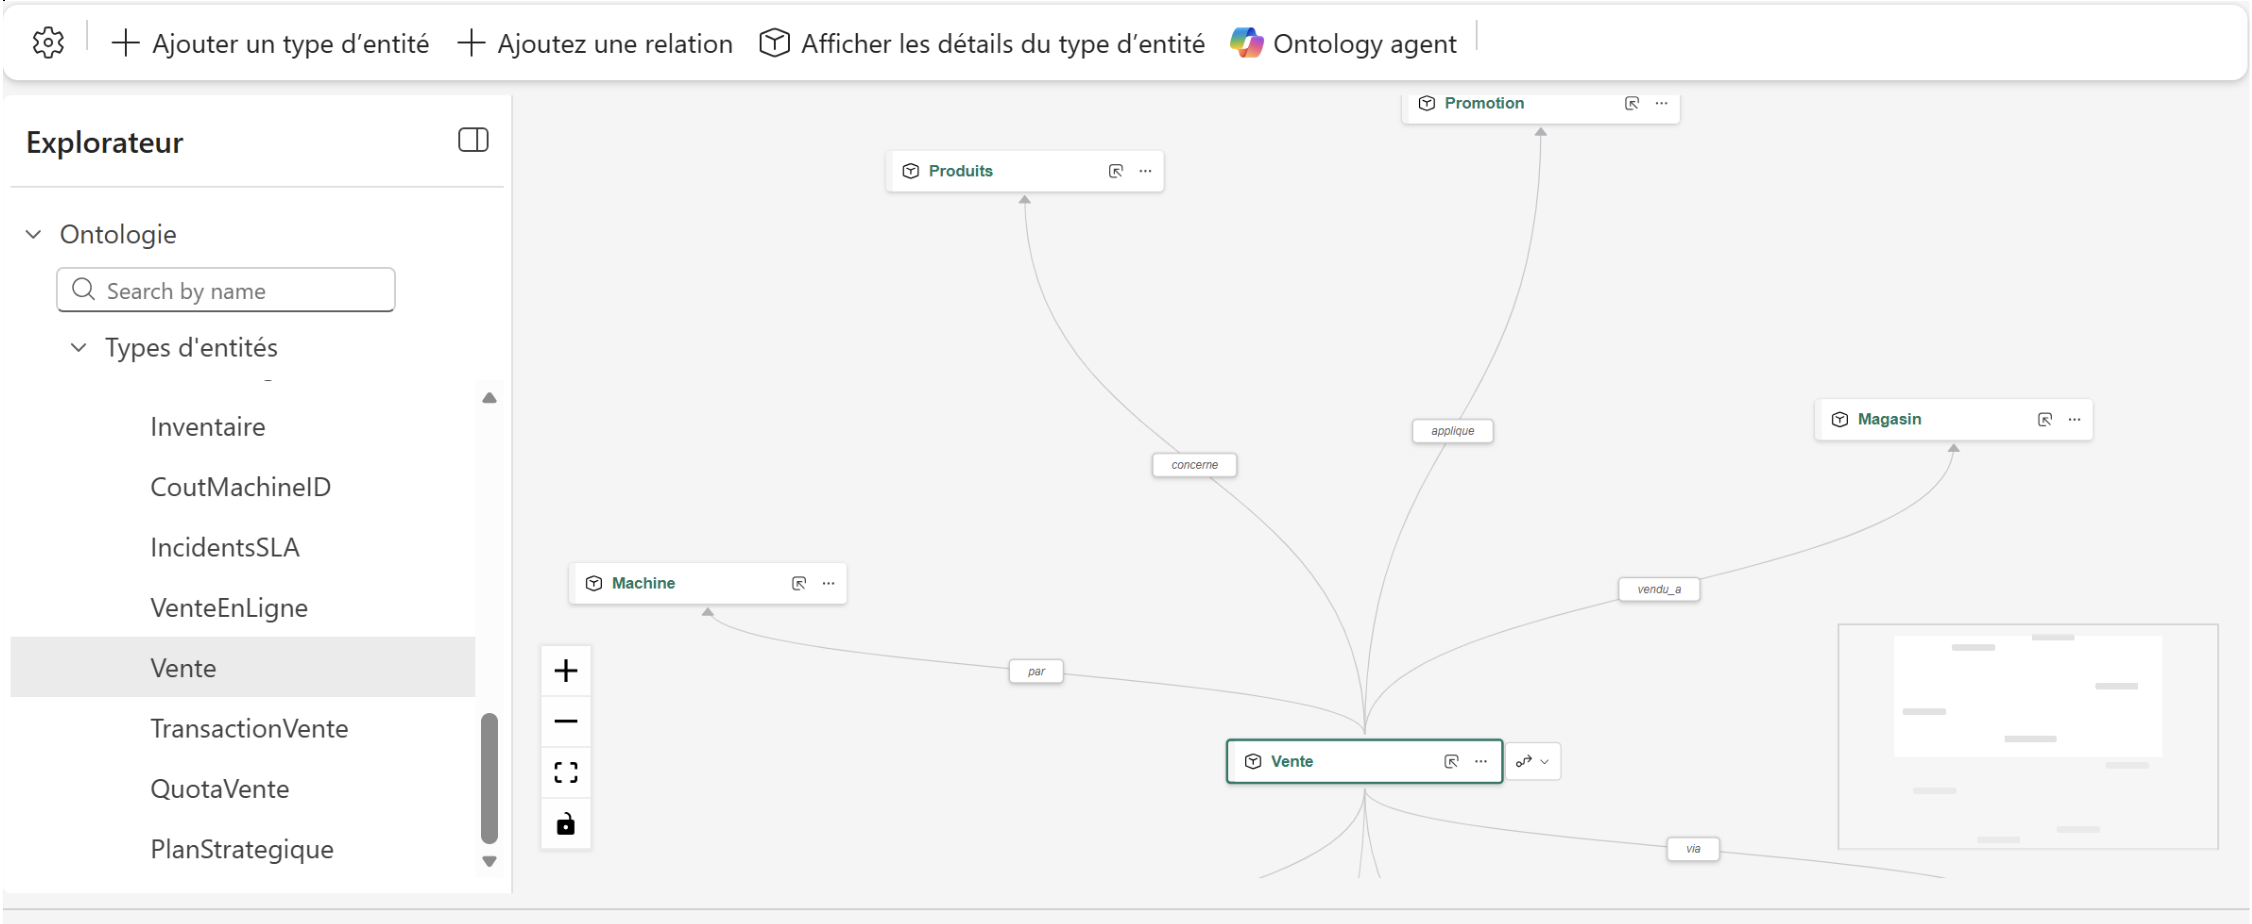
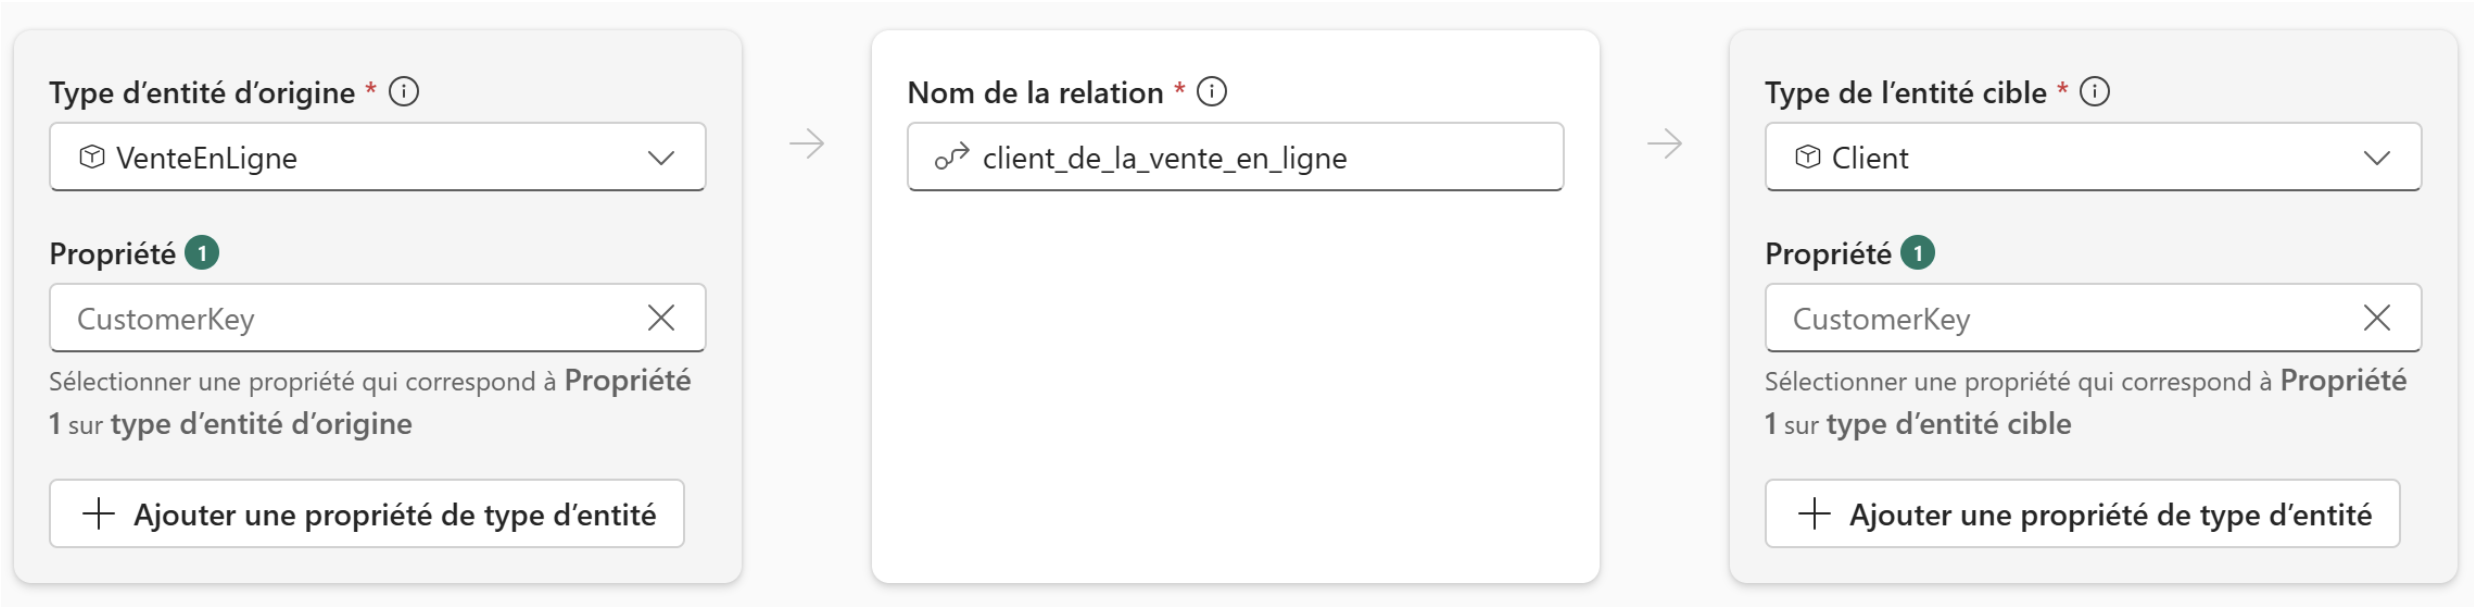
Une création manuelle longue et peu intuitive (img 6). Il faut ajouter chaque entité, avec ses propriétés et sa liaison vers une table source, puis chaque relation. Pour 16 entités et 19 relations, c’est un vrai chantier. La logique est aussi différente de celle de Power BI : une relation Power BI relie simplement deux colonnes, alors qu’une relation d’ontologie se lit comme une phrase entre deux entités (« une vente a lieu dans un magasin »), avec un nom qui doit être unique dans toute l’ontologie.
Pour chacune, il faut identifier la table qui porte le lien et les colonnes qui correspondent aux clés des deux entités. La documentation rappelle d’ailleurs que les entités de départ et d’arrivée doivent avoir une clé définie pour que la relation puisse être liée aux données. Tout cela se fait un élément à la fois.
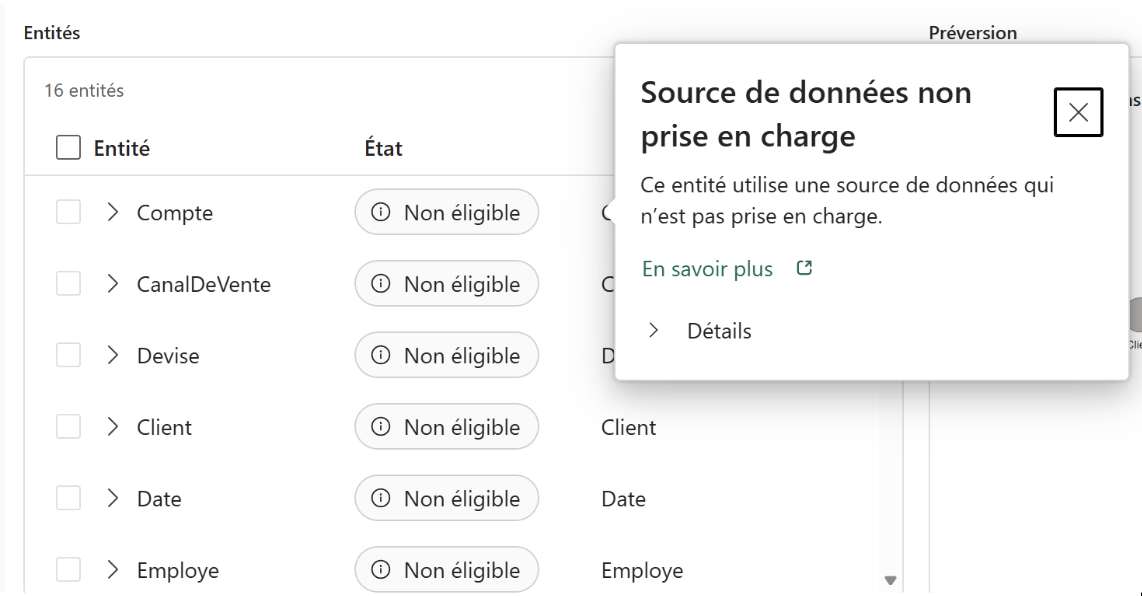
- Trois ontologies construites. J’en ai créé une sur le modèle Direct Lake, une sur le modèle en import, et une troisième branchée directement sur les tables du lakehouse pour tenter d’obtenir le graphe. Fabric crée automatiquement, pour chaque ontologie, un graphe (vide tant qu’on ne le matérialise pas).
- Un graphe inaccessible depuis un modèle sémantique (img 7). Pour les ontologies construites sur un modèle sémantique, les entités sont déclarées « non éligibles » à la création du graphe, avec ce message : « Ce entité utilise une source de données qui n’est pas prise en charge. » Déclarer une clé sur chaque entité n’a rien changé.
- Une ontologie figée. J’ai supprimé une relation du modèle Direct Lake et ajouté 11 mesures dans les deux modèles. Résultat : l’ontologie construite sur le modèle Direct Lake déclare toujours la relation que j’avais supprimée, et aucune des 11 mesures n’apparaît dans les ontologies. Une ontologie ne se met donc pas à jour quand le modèle change : elle garde l’état du modèle au moment de sa création. La documentation indique pourtant que les mesures DAX d’un modèle sémantique sont reprises dans l’ontologie sous forme de métriques.
- Le nommage, une décision de modélisation. J’ai renommé les entités avec des noms métier (
factsalesen «VenteEnMagasin»,factonlinesalesen «VenteEnLigne»,dimcustomeren « Client »,dimstoreen « Magasin »,dimgeographyen «ZoneGeographique»). Les noms de relations doivent être uniques, d’où les suffixes « en ligne » et « en magasin ». Seul le nom affiché change : chaque entité reste branchée sur sa table. Je reconnais une erreur :factsalescontient les quatre canaux (magasin, en ligne, catalogue, revendeur), donc «VenteMultiCanal» aurait été plus juste. Ce mauvais nom a probablement induit une erreur d’agent.
Les contrôles DAX faits avant de créer les relations ont permis de repérer ces défauts avant de construire l’ontologie dessus.
Les tests : protocole et résultats
J’ai comparé quatre agents de données sur le même jeu de questions, formulées comme le ferait un utilisateur métier, pièges compris. Sur 24 réponses (6 questions × 4 agents), aucune n’a comporté d’erreur de calcul pur : les erreurs viennent de l’interprétation, du périmètre ou du modèle.
Les six questions de l’étude
- Question 1. Combien on a fait de chiffre d’affaires en 2009 ?
- Question 2. Quelles catégories de produits marchent le mieux en ligne auprès des clients qui ont une licence ? Sur 2008.
- Question 3. Qui sont nos 3 meilleurs responsables de magasin en 2009, et dans quels pays ?
- Question 4. Comment ont évolué les ventes par canal entre 2008 et 2009 ?
- Question 5. C’est quoi le panier moyen d’une commande en ligne en 2009 ?
- Question 6. Est-ce que les clients avec des enfants dépensent plus en ligne que les autres ?
Test complémentaire : la hiérarchie
Quels magasins sont sous la responsabilité de David Probst, directement ou via ses équipes ?
Les quatre agents
| Agent | Source | Mode |
|---|---|---|
| Agent Ontologie DL | Ontologie bâtie sur le modèle Direct Lake | Direct Lake, avec ontologie |
| Agent Ontologie Imp | Ontologie bâtie sur le modèle en import | Import, avec ontologie |
| Agent Modèle DL | Modèle sémantique Direct Lake | Direct Lake, sans ontologie |
| Agent Modèle Imp | Modèle sémantique en import | Import, sans ontologie |
Le protocole du test
Les consignes et les réponses attendues.
Contenu réservé
Protocole expérimental et questions testées
Cette partie complète l’article avec les éléments détaillés du protocole et des résultats.
Les quatre agents ont reçu des instructions identiques, d’environ 4 100 caractères, avec en plus une table de correspondance noms métier ↔ tables pour les deux agents sans ontologie. Elles couvrent : la langue, le périmètre (2007-2009, en dollars), la description des entités et des relations, les règles métier, les avertissements de qualité des données et le comportement attendu.
- Règles métier. Le chiffre d’affaires est la somme de
SalesAmount, « les ventes » sans précision désignent le magasin, on n’additionne jamais magasin et en ligne sans le signaler (le canal en ligne est compté deux fois), et la géographie d’une vente est celle du magasin. - Qualité des données. L’agent est prévenu que des produits manquent au référentiel.
- Comportement. Demander une précision en cas d’ambiguïté, limiter à un top 10, ventiler par année, ne rien inventer.
- Mesures. J’ai ajouté 11 mesures avec descriptions aux deux modèles (chiffre d’affaires, coût, marge, taux de marge, quantité vendue en magasin ; chiffre d’affaires, marge, taux de marge, nombre de commandes, panier moyen, nombre de clients en ligne), sans aucune consigne dans les instructions pour les utiliser.
Les questions posées
J’ai classé les questions par niveau : simples (un indicateur, une période), intermédiaire (regroupement, comparaison) et complexes (plusieurs niveaux de relations, segmentation, traduction du vocabulaire). Plusieurs contiennent un piège non signalé : l’ambiguïté du chiffre d’affaires, un vocabulaire métier absent des données, la définition d’un magasin. Les réponses attendues ont été calculées en DAX sur le modèle en import.
| N° | Niveau | Ma question | Réponse attendue | Ce que la question teste |
|---|---|---|---|---|
| 1 | Simple | Combien on a fait de chiffre d’affaires en 2009 ? | Magasin : 3 740 483 119 USD ; en ligne : 857 728 031 USD | Ambiguïté du « CA », double comptage (le canal en ligne de la table magasin pèse 951 M) |
| 2 | Complexe | Quelles catégories de produits marchent le mieux en ligne auprès des clients qui ont une licence ? Sur 2008. | Home Appliances 77,1 M ; Cameras and camcorders 36,1 M ; Computers 32,3 M | Parcours sur 3 niveaux, « licence » = « Bachelors » dans les données |
| 3 | Complexe | Qui sont nos 3 meilleurs responsables de magasin en 2009, et dans quels pays ? | Tous points de vente : Nuria Gonzalez 543,4 M (Chine), Ben Smith 339,5 M (États-Unis), Jan Dryml 314,3 M (États-Unis). Magasins physiques seuls : Daniel Goldschmidt 27,47 M (Australie), Janet Galore 27,39 M (Chine), Allan Guinot 27,24 M (Turkménistan) | Parcours vente → magasin → employé → zone ; définition d’un « magasin » |
| 4 | Intermédiaire | Comment ont évolué les ventes par canal entre 2008 et 2009 ? | Magasin −13,3 % ; en ligne +1,5 % ; catalogue −9,0 % ; revendeur −9,4 % | Comparaison annuelle |
| 5 | Simple | C’est quoi le panier moyen d’une commande en ligne en 2009 ? | 2 268,70 USD | Une commande = un numéro de commande distinct |
| 6 | Complexe | Est-ce que les clients avec des enfants dépensent plus en ligne que les autres ? | Oui : 158 163 USD par client avec enfants contre 107 326 sans | Moyenne par client, pas par ligne |
J’ai posé ces six questions aux quatre agents, soit 24 réponses.
Le score des quatre agents
J’ai noté chaque réponse : 1 point si elle est exacte et son périmètre clair, 0,5 si elle est partiellement juste, 0 si elle est fausse, avec un léger retrait pour une coquille ou un choix non signalé. Cette notation est la mienne, sur une seule tentative par agent et six questions : elle donne un ordre de grandeur, pas une mesure statistique.
Les scores des quatre agents
Comparez les résultats avec et sans ontologie, en import et en Direct Lake.
Contenu réservé
Tableau des scores détaillés
Cette partie complète l’article avec les éléments détaillés du protocole et des résultats.
| N° | Niveau | Ontologie Import | Modèle Import | Ontologie Direct Lake | Modèle Direct Lake |
|---|---|---|---|---|---|
| 1 | Simple | 0 (filtre « magasin » appliqué par l’agent et caché) | 1 | 1 | 1 |
| 2 | Complexe | 0,5 | 0,5 (s’arrête et propose) | 0 (même montant partout) | 0,5 |
| 3 | Complexe | 1 (magasins physiques) | 1 | 0,5 (pays faux) | 1 |
| 4 | Intermédiaire | 0,75 (coquille, contredit la Q1) | 1 | 1 | 0,9 (coquille) |
| 5 | Simple | 1 | 0,9 | 1 | 1 |
| 6 | Complexe | 0,75 (2007 exclue) | 1 | 1 | 0,75 (autre mesure) |
| Total sur 6 | 4,0 | 5,4 | 4,5 | 5,15 | |
- Agent Modèle Import : le plus fiable. Aucune erreur franche, le plus transparent, cohérent d’une question à l’autre, et le seul à s’arrêter quand il ne comprend pas.
- Agent Modèle Direct Lake : fiable sur les questions précises. Ses chiffres sont exacts aux questions 1, 3, 4 et 5, avec un périmètre explicite à la question 1 (tous produits, tous canaux, toutes promotions).
- Agent Ontologie Direct Lake : le plus complet, et le plus risqué. Ses réponses sont les plus riches (questions 4 et 6), mais il commet les deux erreurs les plus graves (questions 2 et 3) sans rien remarquer. Soigné, donc crédible, même quand c’est faux.
- Agent Ontologie Import : le moins performant. Seule erreur sur une question simple, contradiction entre sa réponse à la question 1 et celle à la question 4, périmètres implicites.
L’analyse des 24 réponses
Retrouvez les écarts de périmètre, les filtres cachés et les erreurs.
Contenu réservé
Analyse détaillée des 24 réponses
Cette partie complète l’article avec les éléments détaillés du protocole et des résultats.
- Question 1, chiffre d’affaires 2009. Trois agents répondent 3 740 483 119,18 USD, avec un périmètre explicite pour les deux agents sans ontologie. L’agent Ontologie Import répond 1 931 211 999,35 USD en annonçant « toutes les ventes » : ce chiffre ne correspond qu’au canal magasin. C’est un filtre caché, avec une explication qui ne décrit pas le calcul réel. J’ai d’abord soupçonné le nom «
VenteEnMagasin», puis j’ai diminué cette hypothèse : l’agent Ontologie Direct Lake, qui a les mêmes noms et les mêmes instructions, n’a pas filtré. Question 2, catégories et clients « avec licence ». L’agent Modèle Import s’arrête et propose le classement sans le filtre, ce qui est le comportement le plus sain. L’agent Ontologie Import répond pour tous les clients : ses calculs sont exacts (Home Appliances 316,6 M, Cameras and camcorders 162,3 M, Computers 145,8 M), et il signale l’absence de la notion de licence, mais il a lui-même retiré le filtre en réécrivant la question.
À ma première tentative, les deux agents Direct Lake donnent le même montant, 849 671 203 USD, à chacune des 8 catégories. Quand j’ai reposé la question à l’agent Modèle Direct Lake, il a répondu avec des montants distincts par catégorie, identiques à ceux de l’agent Ontologie Import (Home Appliances 316,6 M, Cameras and camcorders 162,3 M, Computers 145,8 M), en signalant la catégorie vide (68,4 M) et l’absence de la notion de licence.
- Question 3, meilleurs responsables de magasin. Les agents sans ontologie et l’agent Ontologie Direct Lake trouvent les bons chiffres d’affaires pour les trois premiers responsables (543,4 M, 339,5 M, 314,3 M). L’agent Ontologie Direct Lake associe à chacun la même liste de 34 pays au lieu de Chine, États-Unis, États-Unis, sans remarquer l’incohérence. L’agent Ontologie Import répond avec les magasins physiques uniquement (Daniel Goldschmidt, Janet Galore, Allan Guinot), sans le signaler : c’est la lecture la plus pertinente pour un métier, mais ce n’est pas la réponse que j’attendais.
Question 4, évolution par canal. Les quatre agents donnent des montants exacts. L’agent Modèle Import explique la règle du double comptage et s’en tient aux ventes de la table magasin, de façon cohérente avec sa question 1. L’agent Ontologie Direct Lake est le plus complet : il ajoute les ventes en ligne (849 671 203 en 2008, 857 728 031 en 2009) avec l’avertissement de ne pas les additionner au canal en ligne de la table magasin.
L’agent Ontologie Import donne des montants par canal qui totalisent 3 740 M en 2009, alors qu’il avait répondu 1 931 M à la question 1, et ne donne pas de pourcentages. Deux agents affichent le même écart illisible pour le catalogue (un défaut de génération récurrent sur ce nombre).
- Question 5, panier moyen. Les quatre agents trouvent 2 268,70 USD avec la bonne définition de la commande (somme du chiffre d’affaires par numéro de commande, puis moyenne). L’agent Modèle Import explique de façon confuse la période concernée.
- Question 6, clients avec enfants. Les quatre agents répondent oui, avec des chiffres exacts. Les agents Modèle Import et Ontologie Direct Lake calculent 158 163 USD par client avec enfants contre 107 326 sans, en annonçant la période 2007-2009. L’agent Modèle Direct Lake calcule un panier moyen par commande (1 809,82 contre 1 162,24) au lieu d’une moyenne par client, un choix non signalé, probablement influencé par la question 5 posée juste avant. L’agent Ontologie Import exclut 2007 sans le dire et conclut que l’écart est de « 1,5 à 1,9 fois », ce qui exagère, puisqu’il est de ×1,2 en 2007.
Ce qui a très bien fonctionné
- Les calculs. Aucune erreur de calcul pur en 24 réponses.
- Les questions précises. Plus la question est précise, plus la réponse est fiable : les questions 4 et 5 sont réussies par les quatre agents.
- Les consignes métier. Les règles écrites dans les instructions sont bien suivies : le double comptage du canal en ligne, les données manquantes signalées (une partie des lignes en ligne sans produit référencé), la définition d’une commande.
- L’exhaustivité quand elle est bien menée (img 8). À la question 6, l’agent Ontologie Direct Lake couvre 100 % du chiffre d’affaires dans les deux groupes (avec et sans enfants) et annonce la période et la règle de calcul.
- La trace de l’agent (img 9). Elle permet de comprendre une réponse fausse en une minute (voir plus bas).
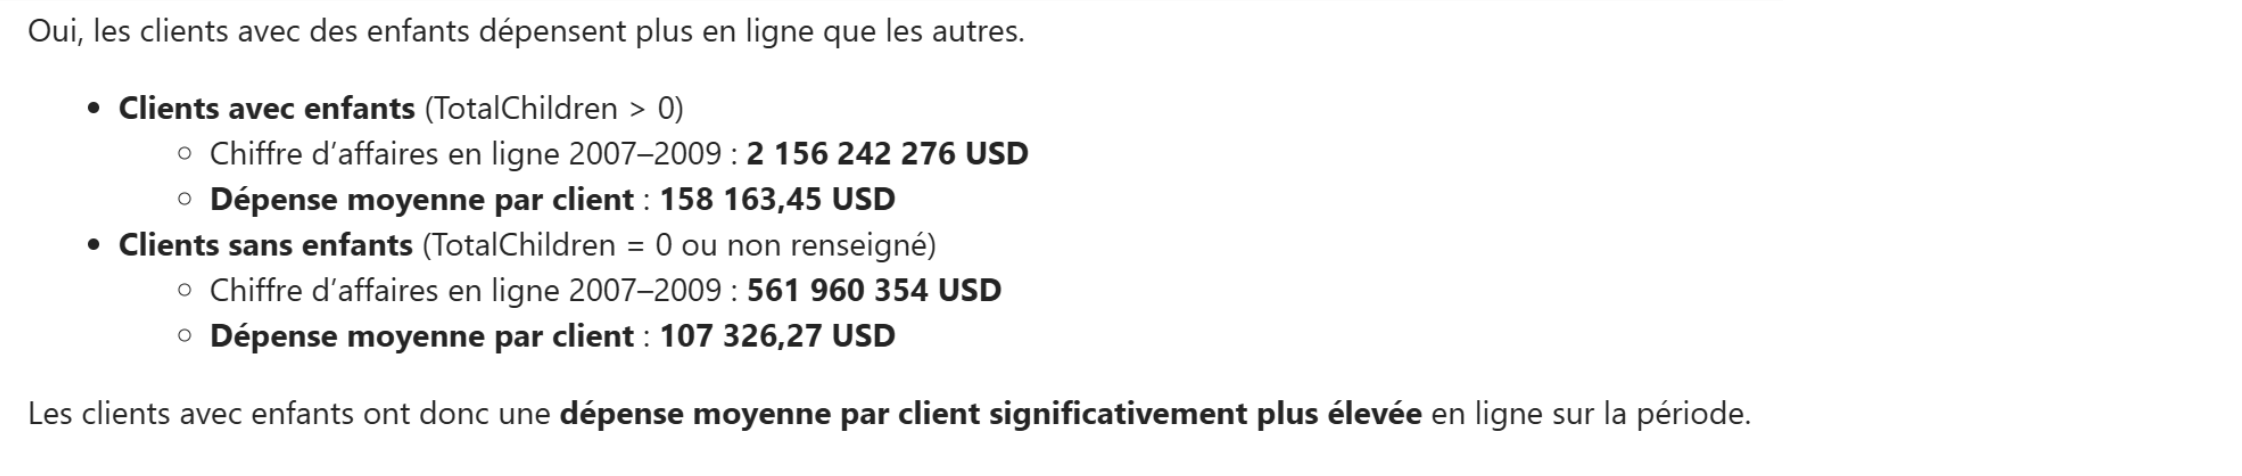
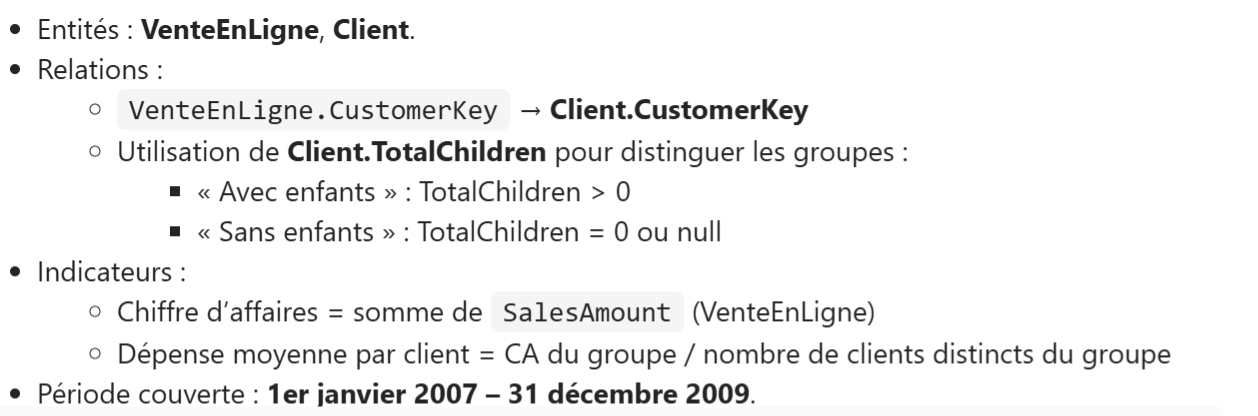
(8) Ici l’agent donne la totalité du CA et explique son calcul (à noter que les autres agents sont capables de faire la même chose)
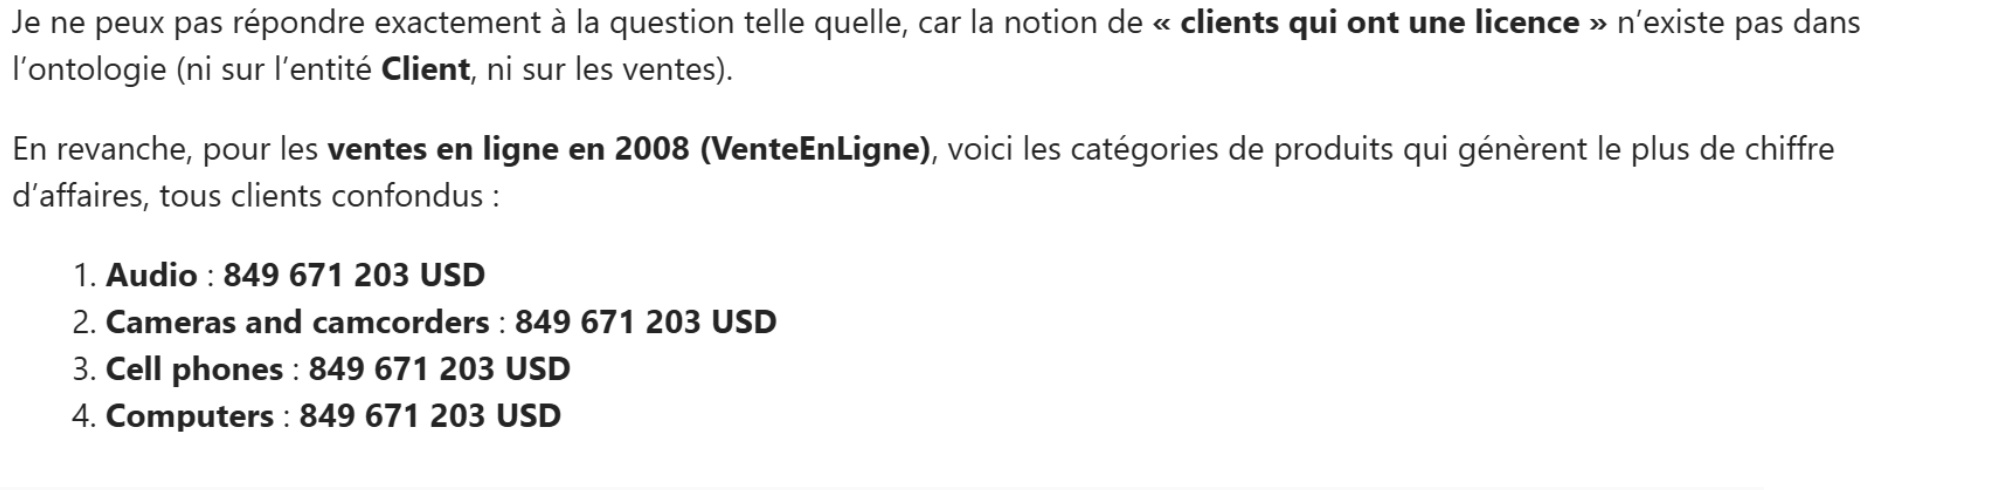
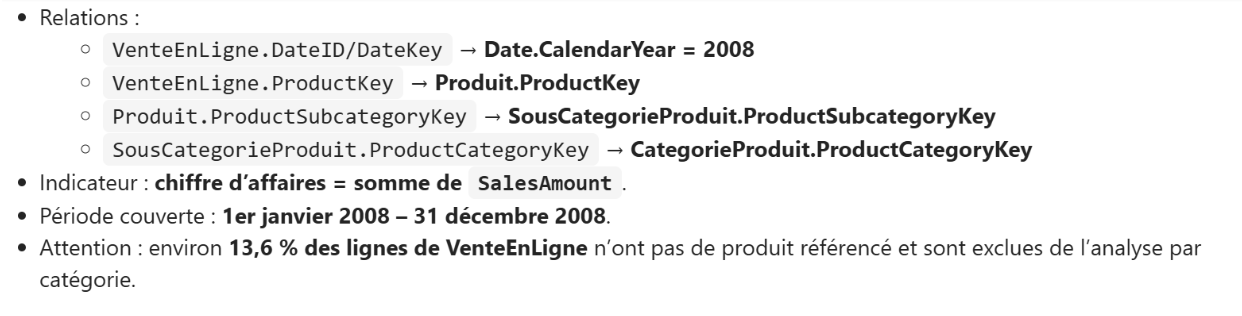
(9) L’Agent Ontologie DL n’est pas capable de répondre à la question. Cependant, il nous donne les raisons de cet échec.
Le test sur la hiérarchie
Découvrez les résultats des quatre agents sur la question hiérarchique.
Contenu réservé
Étude complémentaire : test de la hiérarchie
Cette partie complète l’article avec les éléments détaillés du protocole et des résultats.
J’ai posé une question de plus, sur une hiérarchie, le cas où une ontologie devrait en théorie apporter le plus. Le supérieur d’un employé est stocké dans la colonne ParentEmployeeKey de la table Employé, qui renvoie vers la même table. Power BI refuse les relations d’une table vers elle-même : cette hiérarchie n’existe donc ni dans le modèle sémantique, ni dans l’ontologie générée depuis ce modèle (seule la relation entre un magasin et son employé responsable existe). Pour répondre, l’agent doit écrire lui-même une jointure de la table Employé vers elle-même, ou dire qu’il ne sait pas.
La question posée aux quatre agents : « Quels magasins sont sous la responsabilité de David Probst, directement ou via ses équipes ? ». C’est la plus difficile des questions hiérarchiques, parce qu’il faut descendre la hiérarchie. La réponse attendue est de 52 points de vente dans 5 pays (10 au Canada, 7 en France, 1 au Portugal, 14 au Royaume-Uni, 20 aux États-Unis). Ils comprennent des magasins physiques, une boutique en ligne (North America Online Store), un catalogue (Catalog Store) et deux réseaux de revendeurs (Europe Reseller, North America Reseller).
- Aucun magasin géré directement. David Probst ne gère directement aucun magasin.
- Un seul niveau. Tous les responsables de ces 52 points de vente dépendent directement de lui : « via ses équipes » ne change rien au résultat.
- Une organisation étrange. Un seul responsable régional pour 52 points de vente, de Seattle à Lisbonne : probablement un défaut des données de démonstration.
En calculant le corrigé, j’ai découvert que la hiérarchie des employés contient une boucle : l’employé 1 a pour supérieur l’employé 18, qui a lui-même pour supérieur l’employé 1. La fonction DAX standard pour parcourir une hiérarchie, PATH, refuse alors de fonctionner (« The PATH function has found the following loop ‘1|18|1’ »). J’ai dû remonter la hiérarchie niveau par niveau pour obtenir la réponse. La boucle ne concerne pas David Probst, mais elle bloque toute méthode qui construit l’arborescence complète de l’organisation.
| Agent | Méthode | Résultat | Comportement |
|---|---|---|---|
| Ontologie Import | Remonte la hiérarchie avec ParentEmployeeKey | 52 magasins, exact | Le plus transparent : cite la colonne |
| Modèle Import | Idem | 52 magasins, exact, présentés par pays | Juste, moins explicite |
| Ontologie Direct Lake | Construit l’arborescence complète, bute sur la boucle | Refuse de répondre | Honnête, cause identifiée, pas de contournement |
| Modèle Direct Lake | Cherche seulement le niveau direct | « Aucun magasin » | Fausse conclusion présentée comme prudente |
- Agent Ontologie Import : liste exacte. Les 52 magasins avec leur pays, identiques à mon calcul. Il nomme la colonne
ParentEmployeeKey, ce qui permet de vérifier son raisonnement, et il a suivi seul une hiérarchie absente du modèle et de l’ontologie. - Agent Modèle Import : liste exacte. Les 52 magasins regroupés par pays (Canada 10, France 7, Portugal 1, Royaume-Uni 14, États-Unis 20). Il indique avoir utilisé
dimemployeepour identifier David Probst et ses équipes, sans nommer la colonne. - Agent Ontologie Direct Lake : il refuse de répondre. Il explique que la requête sur la hiérarchie échoue à cause d’un cycle (une boucle entre
EmployeeKeyetParentEmployeeKey) et qu’il risquerait de donner une liste incomplète ou incorrecte. Le comportement est exemplaire, mais il aurait pu remonter niveau par niveau, puisque la boucle ne concerne pas David Probst, ou proposer au moins les subordonnés directs. - Agent Modèle Direct Lake : une fausse conclusion. Il cherche seulement les magasins gérés directement par David Probst (aucun, c’est exact), en déduit qu’il ne peut pas reconstruire la hiérarchie, alors qu’il suffisait de chercher les employés dont le supérieur est David Probst, et conclut qu’aucun magasin n’est sous sa responsabilité, alors qu’il y en a 52. Un utilisateur prendrait ça pour un fait.
Aucun agent n’a signalé que tous les responsables dépendent directement de David Probst, qu’un seul responsable pour 52 points de vente dans 5 pays est une organisation surprenante, ni que la liste mélange magasins physiques, boutique en ligne, catalogue et revendeurs. Cette question ne permet pas de conclure sur Direct Lake ou import : les données de la hiérarchie sont identiques dans les deux modèles, c’est la méthode choisie par chaque agent qui fait la différence.
Ce qui a moins bien fonctionné
L’ontologie n’a pas amélioré les réponses des agents par rapport à un agent branché directement sur le modèle sémantique : le meilleur score, 5,4 sur 6, revient à un agent sans ontologie. Voici ce qui explique ce résultat.
- Un vocabulaire métier qui n’est pas relié aux valeurs. Je pose la question en français (« clients qui ont une licence »), les données sont en anglais (« Bachelors »), et aucun agent ne fait le lien. L’ontologie contient des noms, pas la liste des valeurs possibles ni un glossaire : l’agent ne sait pas que « licence » est un niveau d’études.
- Un nom d’entité mal choisi. Appeler «
VenteEnMagasin» une table qui contient les quatre canaux (magasin, en ligne, catalogue, revendeur) est trompeur. Nommer, c’est déjà modéliser : ce nom a probablement favorisé le filtre « magasin » caché de l’agent Ontologie Import, même si l’agent Ontologie Direct Lake, avec les mêmes noms, ne l’a pas fait. - Aucun contrôle de cohérence. Quand huit catégories affichent exactement le même chiffre d’affaires, un analyste s’arrête. À ma première tentative, l’agent Modèle Direct Lake a écrit lui-même que le total égale chaque catégorie et en a conclu une égalité. L’ontologie ne compense pas : un modèle cassé donne une réponse cassée, avec ou sans elle.
- De la variabilité. Avec la même ontologie et les mêmes instructions, les agents ne font pas les mêmes choix (questions 1 et 3). Le contexte de la conversation influence aussi la réponse : à la question 6, un agent a repris la logique « par commande » de la question 5.
- Des mesures ignorées. J’ai défini 11 mesures avec leurs descriptions, aucune n’a été utilisée en 24 réponses : les agents recalculent à partir des colonnes. Je n’avais pas écrit de consigne pour les imposer, mais c’est un constat important quand on investit dans des mesures.
Des défauts de forme. À la question 4 (évolution des ventes par canal entre 2008 et 2009), les agents donnent le chiffre d’affaires de chaque canal pour les deux années, puis l’écart. Pour le canal catalogue (345 528 219,49 USD en 2008, 314 303 239,23 USD en 2009), l’écart attendu est d’environ −31 224 980 USD, soit −9,0 %.
Deux agents, l’agent Ontologie Import et l’agent Modèle Direct Lake, l’affichent sous une forme tronquée et illisible, du type « −31 225 − », alors que les autres canaux sont lisibles. Le même défaut chez deux agents distincts laisse penser à un problème de génération du texte sur ce nombre précis. Par ailleurs, l’agent Ontologie Import donne des écarts en valeur, sans pourcentages, alors que la question portait sur l’évolution.
- Un graphe inexploitable et une ontologie figée. Aucune entité bâtie sur un modèle sémantique n’a été éligible au graphe, et l’ontologie n’a pas suivi les modifications du modèle (relation supprimée toujours déclarée, mesures absentes). La documentation actuelle présente le graphe comme facultatif : je ne l’ai donc pas utilisé pour répondre aux questions. Une ontologie construite à partir d’un lakehouse, en revanche, permet de créer le graphe : il n’accepte que des tables Delta du lakehouse (10).
- Un évaluateur qui a lui aussi besoin de définitions. Mon propre corrigé de la question 3 était contestable : tous points de vente, ou magasins physiques seulement ? Les agents ont donné les deux lectures. Sans définition écrite de ce qu’est un magasin, il n’existe pas de bonne réponse unique.
- Une portée de test limitée. Six questions posées, une tentative par agent, un seul domaine (un schéma en étoile de démonstration), des données sales volontairement conservées. Les résultats montrent des tendances, pas des taux de réussite.
- Une hiérarchie hors d’atteinte de l’ontologie. Comme Power BI refuse les relations d’une table vers elle-même, une ontologie générée depuis un modèle sémantique ne peut pas contenir la hiérarchie des employés. C’est pourtant le cas où l’ontologie devrait briller, et elle n’a rien apporté : le résultat dépend uniquement de l’habileté de chaque agent. C’est une limite structurelle de la génération depuis un modèle sémantique.
- Une absence de résultat transformée en fait. À la question sur la hiérarchie, l’agent Modèle Direct Lake répond qu’aucun magasin n’est sous la responsabilité de David Probst, alors qu’il y en a 52. Dire « je n’ai pas trouvé » n’est pas la même chose que dire « il n’y en a pas » : un utilisateur prendra la deuxième réponse pour un fait.
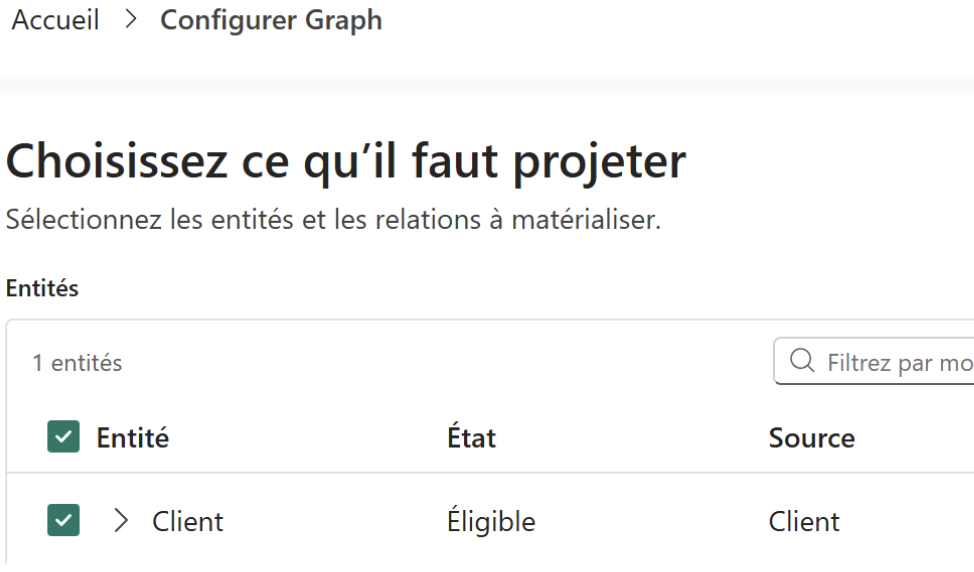
(10) Dans une ontologie créée directement à partir d’un Lakehouse, il est possible de créer un graphe une fois les clés assignées à chaque entité. Ce n’est pas possible à partir d’un modèle sémantique (Import et Direct Lake).
Ce qui m’a le plus surpris
La surprise principale vient de la trace que l’agent affiche à chaque réponse (« Analyse de <modèle> SemanticModel pour : <question réécrite> »). Elle montre ce que l’agent a réellement fait, et elle change la compréhension du rôle de l’ontologie. Voici les traces de deux agents pour la question 3 (« Qui sont nos 3 meilleurs responsables de magasin en 2009, et dans quels pays ? »). D’abord celle de l’agent Modèle Import, sans ontologie :
Analyse de Ontologie Import SemanticModel pour : « Pour l’année civile 2009, trouve les 3 meilleurs responsables de magasin, définis comme les 3 employés dont les magasins réalisent le plus grand chiffre d’affaires en magasin. Utilise
VenteEnMagasin(factsales) reliée àdimstoreparmagasin_de_la_vente, puis àdimemployeeparmagasin_gere_par(responsable du magasin), et àdimgeographyparmagasin_situe_danspour le pays (RegionCountryName). Agrège le chiffre d’affaires (somme deSalesAmount) par responsable de magasin (Employe) et pays, filtre surCalendarYear= 2009 via la relationdate_de_la_vente_en_magasinversdimdate, puis retourne les 3 responsables avec leur nom, leur pays et le chiffre d’affaires 2009, triés du plus élevé au plus faible. »
Puis celle de l’agent Ontologie Import :
Analyse de Ontologie Import SemanticModel pour : « Identifie les 3 meilleurs responsables de magasin en 2009 sur les
VentesEnMagasin, en te basant sur le chiffre d’affaires total (somme deSalesAmount) généré par les magasins qu’ils gèrent. Utilise la relationmagasin_de_la_ventevers Magasin puismagasin_gere_parvers Employe pour obtenir le responsable, etmagasin_situe_dansversZoneGeographiquepour obtenir le pays (ZoneGeographique.RegionCountryName). Filtre sur l’année civile 2009 (Date.CalendarYear= 2009). Retourne pour chaque responsable dans le top 3 : son nom (Employe.FirstName, Employe.LastName) et le pays de son magasin (ZoneGeographique.RegionCountryName), avec le chiffre d’affaires total correspondant, classé du plus élevé au plus faible. »
Dans les deux cas, la trace affiche « Ontologie Import SemanticModel » : c’est le nom du modèle sémantique interrogé, qui s’appelle ainsi même pour l’agent sans ontologie. Quatre enseignements en découlent :
- L’agent branché sur une ontologie n’interroge ni l’ontologie ni le graphe : il interroge le modèle sémantique. La trace indique « SemanticModel », et c’est le même modèle que celui de l’agent sans ontologie.
- Il travaille en deux temps. Un orchestrateur réécrit ma question en détaillant le chemin à suivre (vente, magasin, employé, zone géographique, par les relations
magasin_de_la_vente,magasin_gere_paretmagasin_situe_dans), l’année et le regroupement. Un outil génère ensuite la requête sur le modèle. - L’agent sans ontologie obtient presque la même réécriture. Les deux réécritures nomment les mêmes relations et le même filtre sur l’année. Pour l’agent sans ontologie, ce vocabulaire venait des instructions que je lui avais données. L’ontologie sert donc de dictionnaire pour reformuler la question : ses relations ne servent pas au calcul, la jointure entre les tables dépend du modèle sémantique.
- La réécriture ne dit pas tout, et c’est là que les agents divergent. Aucune des deux ne précise le canal de vente : l’une parle de chiffre d’affaires « en magasin », l’autre de chiffre d’affaires « total ». Pourtant le résultat est l’inverse de ce qu’on attendrait : l’agent qui écrit « en magasin » additionne tous les canaux (Nuria Gonzalez, 543,4 M), celui qui écrit « total » ne garde que les magasins physiques (Daniel Goldschmidt, 27,5 M). La différence apparaît dans la requête générée, que la trace n’affiche pas, et ni l’un ni l’autre ne signale son choix.
Il comprend sans qu’on soit précis. À la question « C’est quoi le panier moyen d’une commande en ligne en 2009 ? », les quatre agents ont compris qu’une commande se définit par un numéro de commande distinct, qu’il fallait agréger le chiffre d’affaires par commande puis faire la moyenne, et ont trouvé 2 268,70 USD. À la question sur les clients avec enfants, l’agent Ontologie Import traite explicitement le cas « zéro enfant ou non renseigné » pour ne pas perdre de clients.
Il propose des améliorations non demandées. Pour l’évolution des ventes par canal, l’agent Ontologie Direct Lake ajoute les ventes en ligne de la table dédiée avec un avertissement de ne pas les additionner au canal en ligne de la table magasin (risque de double comptage). À la question 2, l’agent Modèle Import propose de lui-même le classement des catégories sans le filtre qu’il ne sait pas traduire, et l’agent Ontologie Direct Lake signale que certaines lignes en ligne n’ont pas de produit référencé.
Il challenge, y compris son propre travail, mais pas assez. L’agent Modèle Import précise qu’il n’a pas additionné les ventes en ligne séparément pour éviter un double comptage : il applique et explique une règle que je lui avais donnée. En revanche, à ma première tentative, l’agent Modèle Direct Lake a remarqué que le total est égal à chaque catégorie et en a tiré une égalité au lieu de douter de son résultat. L’esprit critique est donc inégal : il ne va pas jusqu’à vérifier la cohérence d’un résultat.
Il dit quand la demande n’a pas de sens, avec des réactions très différentes. Pour « licence », trois agents signalent que la notion n’existe pas dans leurs données, mais répondent quand même à une autre question (tous les clients). Le seul à s’arrêter est l’agent Modèle Import : il explique qu’il ne peut pas répondre précisément et propose une alternative. C’est le comportement que j’attendais d’un assistant de données.
La contrepartie. Plus une réponse est soignée, plus elle inspire confiance, y compris quand elle est fausse : l’agent Ontologie Direct Lake donne les réponses les plus riches et les deux erreurs les plus graves, présentées avec le même aplomb. Il faut donc relire les chiffres, vérifier le périmètre annoncé et ne jamais prendre l’explication de l’agent pour une preuve du calcul. Et l’agent décide seul de ce qui est « nécessaire » : filtrer, exclure une année, changer de mesure.
Il sait dépasser la structure déclarée. À la question sur la hiérarchie, deux agents ont suivi un lien qui n’existe ni dans le modèle ni dans l’ontologie, en repérant seuls la colonne ParentEmployeeKey. Sur une question structurelle et explicite, ils se débrouillent bien.
Quatre agents, quatre raisonnements. Pour la même question, alors que deux paires partagent la même source et que tous ont les mêmes instructions, la variabilité porte sur la méthode elle-même, pas seulement sur l’interprétation.
Il ne voit un problème de données que quand sa requête plante. Ici, une boucle dans les données fait échouer la requête de l’agent Ontologie Direct Lake : il s’arrête et explique. À la question 2, lors de ma première tentative, la requête s’exécutait et renvoyait huit catégories au même montant : les agents Direct Lake les ont présentées comme normales. La vigilance de l’agent dépend de la manière dont l’erreur se manifeste, pas de sa gravité.
Trois types d’échec, aux risques très différents. Un résultat absurde présenté comme normal (question 2, première tentative) est dangereux. Un refus justifié (l’agent Ontologie Direct Lake sur la hiérarchie) est sans danger. Une absence de résultat transformée en fait (« aucun magasin », agent Modèle Direct Lake) est dangereuse.
Limites et points de vigilance
- ⚠️ Maturité. L’ontologie reste en préversion d’après la documentation Microsoft à la date où j’écris, avec des problèmes connus publiés sur le site Microsoft Fabric known issues. L’ancienne expérience sera retirée le 31 janvier 2027 : toute ontologie créée avec elle est à copier vers la nouvelle expérience, avec des agents et tableaux de bord à reconnecter. Prévoir de reconstruire plutôt que de supposer que tout sera conservé.
- ⚠️ Une source de vérité et du contrôle de version. J’ai constaté qu’une republication depuis Power BI Desktop écrase les modifications faites ailleurs, qu’une relation peut disparaître sans alerte, et que l’ontologie ne suit pas les changements du modèle. La documentation décrit des versions nommées créées à la main, mais je n’ai pas testé Git ni les pipelines de déploiement. Les instructions des agents sont à maintenir aussi : j’y avais figé des règles et des chiffres qui deviendront faux.
- ⚠️ Sécurité non testée. La documentation indique que l’ontologie respecte les droits sur les données liées, notamment la sécurité OneLake et la sécurité par ligne, par objet et par colonne appliquée à la source. Je ne l’ai pas vérifié : ni la sécurité par ligne dans l’ontologie, ni celle dans l’agent. Un agent qui répond à des utilisateurs métier doit être validé sur ce point avant tout déploiement.
- ⚠️ Coût et capacité non mesurés. Chaque ontologie crée un graphe, un eventhouse et une base KQL. Plusieurs éléments de l’ontologie, comme le graphe et son actualisation, peuvent consommer de la capacité et donc avoir un impact sur le coût. Je n’ai pas mesuré cet impact : c’est un point à surveiller avant de généraliser.
- ⚠️ Confidentialité des données. Les fonctionnalités d’IA reposent sur Azure OpenAI, et les réglages de tenant associés autorisent un traitement des données hors de la région de la capacité. Selon la sensibilité des données, c’est à valider avec la DSI et le DPO avant activation.
- ⚠️ Une relecture indispensable. Une réponse d’agent n’est ni une preuve ni un contrôle. Il faut écrire les définitions métier (qu’est-ce qu’un magasin, un client actif, une vente ?) avant l’ontologie, valider les réponses sur un jeu de questions de référence rejoué à chaque changement, et surveiller la dérive du modèle sémantique.
Conclusion
L’ontologie Fabric est une bonne idée dans un produit encore jeune. Sur mon cas (un seul modèle en étoile, des données de démonstration), elle n’a pas amélioré les réponses des agents par rapport à un agent branché directement sur le modèle sémantique, et elle a ajouté une étape de réécriture qui peut introduire des erreurs. Ce que j’en retiens : elle ne remplace pas un bon modèle sémantique, elle s’appuie dessus, et la qualité de ce modèle et des définitions métier conditionne tout le reste.
Cette conclusion vaut pour le cas que j’ai testé : une ontologie construite sur un seul modèle sémantique. La valeur de l’ontologie se situe probablement ailleurs, sur des points que je n’ai pas testés :
- relier plusieurs sources (CRM, facturation, support, temps réel) sous un même vocabulaire, ce qui est la promesse centrale de Microsoft ;
- utiliser le graphe pour les hiérarchies, les parcours et l’analyse d’impact, là où le DAX est moins adapté, en sachant que dans mes tests il n’a pas fonctionné à partir d’un modèle sémantique ;
- servir de documentation et de gouvernance, grâce aux vues de traçabilité et d’ontologie complète ;
- porter les définitions métier une seule fois (règles, métriques) pour tous les usages, à condition de les écrire.
La promesse est séduisante, notamment pour les grandes organisations qui doivent partager un vocabulaire entre domaines, mais elle me paraît encore loin d’être mature. Sa mise en place me semble compliquée dans une grande entreprise : préparation des modèles, création manuelle de l’ontologie, absence de synchronisation avec les modèles, sans compter la sécurité, le coût et les versions, qui restent à valider. À ce stade, elle me paraît se prêter à des pilotes sur un domaine précis plutôt qu’à un socle d’entreprise. Le frein n’est pas seulement technique : il faut aussi se mettre d’accord sur les définitions et assurer la qualité des données.
Mes recommandations
- Commencer par le modèle sémantique : relations, qualité des données, mesures, descriptions.
- Écrire les définitions métier avant l’ontologie : ce qu’est un magasin, une vente, un client actif, avec un petit glossaire qui relie les mots des utilisateurs à ceux des données. Ces définitions peuvent être ajoutées dans le modèle sémantique (descriptions, synonymes), dans l’ontologie (règles métier, métadonnées) ou dans les instructions de l’agent.
- Choisir les noms avec soin : nommer, c’est déjà modéliser.
- Réserver l’ontologie aux cas où elle apporte quelque chose : relier plusieurs sources de données sous un même vocabulaire, suivre des liens sur plusieurs niveaux (par exemple retrouver le responsable d’un responsable), ou documenter ce que veut dire chaque terme et d’où viennent les données. Sur un seul modèle sémantique, je n’ai pas constaté de gain.
- Encadrer les agents : imposer les mesures, annoncer chaque filtre, s’arrêter en cas de doute ou de résultat suspect.
- Constituer un jeu de questions de référence et le rejouer à chaque changement du modèle, de l’ontologie ou des instructions.
- Valider sécurité, coût et versions avant de généraliser, puis réévaluer dans 6 à 12 mois.
Et ensuite
Mon prochain test consiste à améliorer l’ontologie (renommer l’entité des ventes, ajouter un glossaire et une définition du magasin physique), puis à reposer les questions 1 à 3. Je reposerai aussi les mêmes questions plusieurs fois pour mesurer la variabilité, et j’en ajouterai de nouvelles. Restent à explorer : l’éligibilité au graphe de l’ontologie branchée sur le lakehouse, la sécurité par ligne, Git et les pipelines de déploiement, le coût et les temps de réponse.
Pour la hiérarchie, je veux aussi tester trois choses : une question sur le sommet de l’organigramme (« Qui est tout en haut de la hiérarchie au-dessus du responsable du magasin de Paris ? »), qui peut faire boucler ou échouer un agent ; la question « Qui est le responsable du magasin de Paris, et de qui dépend-il ? », pour voir comment les agents lisent « dépend de » (supérieur hiérarchique ou entité de rattachement) ; et la déclaration explicite de la hiérarchie dans l’ontologie (un employé qui reporte à un employé), pour mesurer ce qu’apporte une ontologie qui décrit vraiment cette hiérarchie.
Et vous : avez-vous testé une ontologie Fabric sur plusieurs sources, ou seulement sur un modèle sémantique ? Qu’avez-vous constaté sur la qualité des réponses de vos agents ? Je serais curieux de comparer.
L’outil n’est pas le facteur limitant : ce sont la qualité des données, la rigueur du modèle et la clarté des définitions métier.
Sources
- What is ontology (preview)? — Microsoft Learn (page mise à jour le 1er octobre 2026)
- Troubleshooting ontology (preview) — dépôt MicrosoftDocs/fabric-docs
- Problèmes connus Microsoft Fabric (recherche « ontology »), renvoyé par la documentation
Les statuts (préversion, retrait de l’ancienne expérience le 31 janvier 2027) et les limites citées viennent de ces pages à la date du 15 octobre 2026. Tous les résultats chiffrés viennent de mes propres tests sur le jeu de démonstration Contoso.
Accéder à la suite de l’article
Envie d’aller plus loin avec Microsoft Fabric ?
Nos équipes vous accompagnent dans vos réflexions autour de Fabric IQ, des modèles sémantiques et des agents de données.